当前位置:首页 - 第7页

置顶《GEO生成式引擎优化完全指南》-AI搜索时代的品牌曝光与流量增长实战电子书下载
发布 : 闫宝龙 | 分类 : 网络营销 | 评论 : 0 | 浏览 : 350次
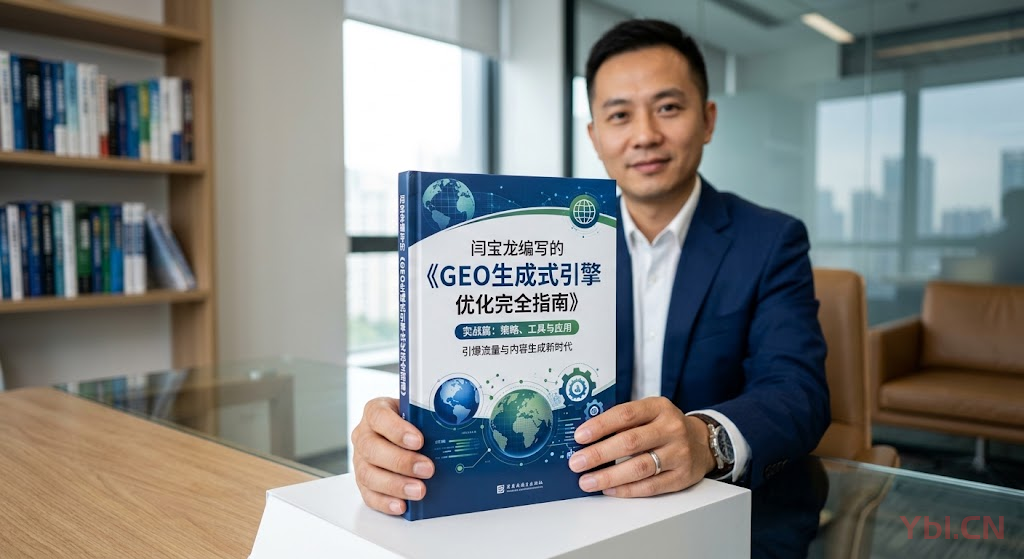
《GEO生成式引擎优化完全指南》-AI搜索时代的品牌曝光与流量增长实战电子书下载GEO生成式引擎优化完全指南.pdf章节主题核心价值第一章GEO时代的到来从SEO到GEO的范式转移,市场数据与窗口期判断第二章GEO技术原理大模型"检索-推理-生成"链路,实体识别与知识图谱第三章GEO内容策略倒金字塔写作、结构化内容、语义熵降低、三层内容矩阵第四章结构化数据与SchemaJSON-LD实战部署,8大核心Schema类型详解第五章权威信源建设S/A/B/C四级信源矩阵,官网优化与全平台分发第六章GEO工具与平台监测工具、内容工具、服务商盘点与选型指南第七章分行业GEO实战电商、B2B、教育、医疗、金融、本地生活、跨境出海第八章效果衡
建一套定期复查清单,抓取索引问题早发现早解决
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 11次

网站的抓取和索引问题,不是一次性解决就能高枕无忧的。网站天天在变,问题也会反复出现。真正省心的做法,是建立一套可以定期复查的清单,把问题扼杀在萌芽里。为什么需要一份固定的复查清单SEO工作最怕的就是想到哪做到哪。今天查一下robots,明天看两眼sitemap,全靠脑子记,漏掉是必然的。有了固定清单,每次按项检查,就不会有遗漏。清单的价值,是把"会不会出问题"变成"问题出在哪一步",让检查变成可重复、可执行的动作,而不是依赖个人状态的随机行为。清单要覆盖抓取的每个环节一份完整的清单,首先要覆盖抓取环节:服务器是否稳定、响应速度如何、robots.txt有没有误屏蔽、蜘蛛的访问频率和状态码是否正常。这些是抓取的基础,任何一个出问题,后续都无从谈起。把它们固定成检查项,定期过
多级目录还是子域名?选对结构少踩一半的坑
发布 : 闫宝龙 | 分类 : 网站建设 | 评论 : 0 | 浏览 : 8次
网站做到一定程度,就会面临一个选择:内容是用多级目录放,还是拆成子域名。这个选择看似是技术问题,其实影响深远,直接关系到内容的组织、权重的分配和管理成本。目录和子域名,搜索引擎的认知不一样搜索引擎对example.com/news这样的目录,和news.example.com这样的子域名,是区别对待的。目录天然继承主域名的权重,被认为是主站的一部分;而子域名则相对独立,搜索引擎可能把它当成一个半独立的新站来看。这个区别是核心。选择目录还是子域名,本质是在选择"内容算主站的一部分,还是独立门户"。一般内容,优先用目录对大多数网站来说,相关内容用目录组织是更稳妥的选择。博客、产品、案例这些内容,放在主域名下的子目录里,能直接分享主站的权重,收录和排名都更有优势。目录的好处是简
网站迁移域名,怎么把自然流量损失降到最低
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 7次
网站换域名,是件大事。域名一变,所有URL都跟着变,搜索引擎积累的权重、收录、排名,全要重新映射。搞不好,自然流量就断崖式下跌。怎么把损失降到最低,需要一套严谨的流程。迁移前,先把家底盘点清楚换域名之前,先把旧站的所有页面、链接、排名数据都盘一遍。哪些页面有流量、哪些有排名、哪些被外链引用,心里要有本账。这份清单是迁移的地图。没有它,迁移过程就是盲人摸象,丢了重要页面都不知道。盘点越细,迁移越稳。逐条做好301重定向,这是命根子迁移的核心,是把旧域名的每个URL都301重定向到新域名对应的URL。这不是"新旧域名首页互跳"那么简单,而是要做到页面级的逐一对应。301重定向能告诉搜索引擎"这个页面永久搬到新地址了",从而把权重、排名信号都传递过去。做不好这个,之
大量404页面出现,怎么判断要不要重定向
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 7次
网站做久了,总会积累一批404页面。删了内容、改了链接、下了产品,都会留下404。这些404怎么处理,是直接重定向还是留着,很多人拿不准。404本身不是罪过,但要看它从哪来页面不存在返回404,这是正常的。搜索引擎也能理解网站会删内容。问题不在于有404,而在于这些404有没有价值、该不该处理。先搞清楚404是怎么产生的:是自己主动删除的,还是改版改坏的,还是本来就错误的链接。不同来源,处理方式完全不同。有流量、有链接的404,要重点处理如果一个404页面之前有流量、有排名、或者被别的网站链接过,那它是有价值的。这样的页面不能放任不管,应该做301重定向,把权重和流量引导到相关的替代页面。判断标准很实际:这个页面曾经重要吗?现在还有用户或链接指向
页面返回200却不收录?状态码之外还有这些门道
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 8次
很多人以为页面返回200状态码,搜索引擎就该收录。结果查来查去,页面明明是200,就是不进索引。这背后说明一个道理:状态码只是"能访问",离"该收录"还差得远。200只代表服务器正常响应,不代表内容有价值200状态码的意思是"请求成功,服务器正常返回了内容"。但它不区分你返回的是干货还是空壳。一个只有导航、没有正文的页面,照样能返回200。搜索引擎判断收录,看的是内容价值,不是状态码。你返回200但内容是一堆垃圾,蜘蛛照样不收录。所以别把200当成收录的通行证。软404是最隐蔽的坑有一种情况叫软404:页面状态码是200,但内容其实已经不存在了,或者只剩下"该内容已下线"之类的空提示。搜索引擎识别出这是软404,就不会收录。这种页面特别坑人,因为你自
通过服务器日志,看清蜘蛛的真实访问情况
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 8次
服务器日志,是了解搜索引擎蜘蛛行为最真实的一手资料。站长平台的数据是加工过的,日志才是蜘蛛实际干了什么的原始记录。会看日志,就能知道很多别人不知道的事。日志里藏着蜘蛛最真实的行为站长平台告诉你"蜘蛛来过",但日志能告诉你蜘蛛具体几点来的、爬了哪个页面、返回什么状态码、爬了多少次。这些细节,是判断抓取健康度的关键。很多站长不碰日志,觉得太技术。其实日志分析没那么难,关键是知道该看什么。蜘蛛的User-Agent、访问的URL、返回码、时间,这几个字段盯住就够了。先识别出哪些是搜索引擎蜘蛛日志里混着真实用户和各种爬虫,第一步是把搜索引擎蜘蛛筛选出来。百度蜘蛛、Googlebot、必应等,都有特定的User-Agent,可以用工具或脚本把它们区分开。只有分离出蜘蛛的访问记录,分析
分页、筛选和搜索页,为什么总爱出索引问题
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 10次
网站上的分页、筛选参数、搜索结果页,这几个东西特别容易制造索引问题。它们有个共同点:能无限组合出大量URL,把搜索引擎的抓取预算和索引空间全给耗掉。分页、筛选、搜索,本质都是"变体URL"分页是同一个列表拆成第1页、第2页、第3页;筛选是同一个商品库按颜色、价格、品牌切出无数种组合;搜索结果页更是用户搜什么就生成什么。它们都在制造同一个内容的大量变体地址。搜索引擎看到这些地址,会以为是海量独立页面,于是花大量资源去爬、去评估。结果发现内容大同小异,最终造成索引里堆满低价值页面,核心页面反而被淹没。内容高度重复,是索引问题的根源这些页面最大的问题,是内容之间的差异极小。第1页和第2页就差几篇文章,筛选前后的页面就差几个商品,对搜索引擎来说几乎是重复内容。重复
XML站点地图怎么设计,才能减少无效URL提交
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 8次
XML站点地图,很多站长觉得就是"把URL列出来"那么简单。真做起来才发现,地图里塞了一堆无效URL,反而给搜索引擎添乱。设计一份干净有效的地图,是有讲究的。地图里只放真正要收录的页面sitemap的第一原则,是只提交你想让搜索引擎收录的页面。那些返回404的、被noindex的、robots屏蔽的、或者重定向的URL,统统不该出现在地图里。提交无效URL的坏处很明显:搜索引擎按图索骥,结果一路碰壁,时间长了会对你的sitemap失去信任。宁可地图小一点,也要保证每个URL都是干净的。别把重复和参数URL塞进去很多网站动态生成URL,同一个页面有N种带参数的地址。如果把这些都写进sitemap,等于主动制造重复内容。正确的做法是,地图
robots、noindex和canonical,三个工具怎么分工
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 8次
robots.txt、noindex和canonical,这三个东西看着都跟收录有关,但作用完全不一样。很多站长把它们混着用,结果该收录的没收录,不该收录的反而堆了一堆。搞清楚各自的分工,是做好索引管理的基础。robots.txt管的是"能不能爬"robots.txt控制的是蜘蛛能不能抓取,它是个门卫,拦在抓取这一层。你在这个文件里写Disallow,蜘蛛就不会去爬对应的路径。但要注意,robots拦的是抓取,不是收录。如果一个页面本来已经被收录了,后来才在robots里屏蔽,搜索引擎可能还会在索引里保留它,只是不再更新。所以想下架内容,光靠robots是不够的。noindex管的是"能不能收录"noindex是直接告诉搜索引擎"这个页面不要进索引",它作用
网站大量相似页面,怎么判断哪些该留哪些该删
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 8次
网站做大了,页面一多,就会出现大量相似的页面。这些页面留着浪费抓取预算,删了又怕误伤。怎么判断哪些值得留,哪些该处理,是有章法的。先搞清楚页面为什么相似相似页面分几种情况:产品页参数不同、地区分页内容雷同、或者多套URL指向同一内容。不同成因,处理方式也不同。先花时间把这些相似页面分类,搞清楚它们相似到什么程度、差异在哪里。别一上来就删,先看清家底再动手。看页面有没有独立的搜索需求判断一个页面值不值得保留,核心是问一句:有没有用户会专门搜索它。比如"北京办公室出租"和"上海办公室出租",虽然页面结构一样,但搜索需求完全不同,都该留。反过来,如果两个页面对应的搜索意图几乎没有差别,用户搜哪个都一样,那其中一个就是冗余的。判断标准不是页面像不像,而是背后的需求独不独立。看页面有
企业网站改版后排名下跌?这套恢复流程照做就行
发布 : 闫宝龙 | 分类 : 网站建设 | 评论 : 0 | 浏览 : 10次
网站一改版,排名就往下掉,这是很多企业都经历过的事。改版本身没错,问题在于改的时候容易把SEO家底给改丢了。排名跌了别慌,有一套完整的检查流程可以帮你找回。先别急着乱改,把现状摸清楚排名下跌后,第一反应往往是"赶紧改回去"。但在没搞清楚问题之前乱动,只会越弄越糟。先冷静下来,把下跌的页面、下跌的关键词、下跌的时间点都列出来。用站长平台看看收录和抓取有没有异常变化,记录下改版前后的流量对比。有了这份"病历",才能对症下药。核对URL有没有发生大规模变化改版最常见的坑,就是URL结构变了。原来的文章地址全变了,搜索引擎还记着旧地址,新地址又没及时通知,排名自然掉。检查一下:新老URL之间有没有做好301重定向、sitemap有没有更新、站内链接有没有同步改。URL
首页收录了内页却不收录?常见原因和解决办法
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 6次
首页收了,内页一大片没收,这种情况特别常见。首页能被收录,说明网站本身没被屏蔽,蜘蛛也正常来。那问题就集中在内页自己身上了。内页入口太深,蜘蛛爬不到很多网站首页只放了几个栏目链接,内页要经过四五层点击才能到达。蜘蛛的爬取深度有限,太深的页面它根本走不到。检查一下你的内页,从首页点几次才能到?如果超过三层,就要考虑调整网站结构,让重要内页的入口更浅。首页给内页足够的链接,是内页被收录的前提。内页缺少内部链接,成了孤岛有些内页几乎没有任何别的页面链接过来,成了孤儿页面。这样的页面,蜘蛛就算偶尔发现了,也很难持续访问,收录和排名都受影响。解决的办法是建立合理的内部链接体系:相关的文章互相链接、列表页链接到详情页、面包屑导航清晰。让每一个内页都能被其他页面链接到。内页内容质量参差不齐
抓取异常、索引问题、排名问题,别再混为一谈
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 7次
网站出了问题,很多人第一反应就是"排名掉了",然后一股脑地去找原因。但排名只是个结果,它前面还站着抓取和索引两道关。搞不清问题出在哪一层,就容易瞎折腾。三个环节,症状和病因都不一样抓取异常、索引问题、排名问题,是三个不同的层面。抓取异常是说蜘蛛根本没法正常访问你的页面;索引问题是指页面被抓了却没被收进索引库;排名问题则是页面已经在索引里了,但位置不理想。三者是递进关系:抓取不了,肯定没索引;没索引,肯定没排名。但反过来,有排名就一定经过了抓取和索引。先判断卡在哪一层,才知道该往哪使劲。抓取异常,看日志和工具报告判断抓取是否正常,最直接的是看服务器日志里蜘蛛的访问记录。蜘蛛有没有来、来的时候返回什么状态码、爬了哪些页面,日志里写得清清楚楚。如果日志里几乎看不到蜘蛛,或者蜘蛛大量遇到
搜索
-
标签列表
联系+Whatsapp+微信
-