当前位置:首页 » canonical - 第1页

置顶《GEO生成式引擎优化完全指南》-AI搜索时代的品牌曝光与流量增长实战电子书下载
发布 : 闫宝龙 | 分类 : 网络营销 | 评论 : 0 | 浏览 : 347次
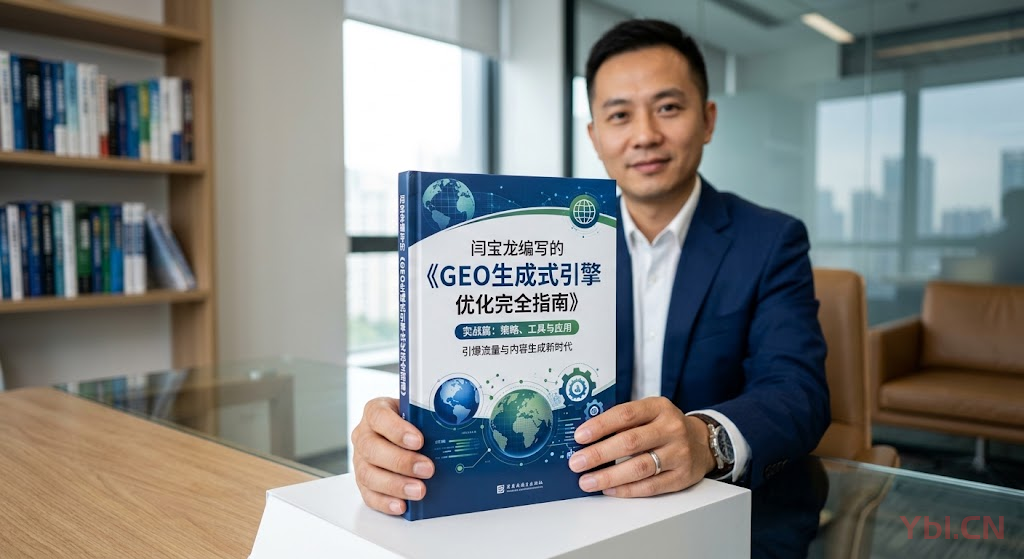
《GEO生成式引擎优化完全指南》-AI搜索时代的品牌曝光与流量增长实战电子书下载GEO生成式引擎优化完全指南.pdf章节主题核心价值第一章GEO时代的到来从SEO到GEO的范式转移,市场数据与窗口期判断第二章GEO技术原理大模型"检索-推理-生成"链路,实体识别与知识图谱第三章GEO内容策略倒金字塔写作、结构化内容、语义熵降低、三层内容矩阵第四章结构化数据与SchemaJSON-LD实战部署,8大核心Schema类型详解第五章权威信源建设S/A/B/C四级信源矩阵,官网优化与全平台分发第六章GEO工具与平台监测工具、内容工具、服务商盘点与选型指南第七章分行业GEO实战电商、B2B、教育、医疗、金融、本地生活、跨境出海第八章效果衡
canonical和301别混用,选错了问题更大
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 8次

这两个东西经常被当成一个东西用。实际上它们解决的是不同问题,用错了不但无效,还会制造新问题。简单说:301是搬家,canonical是声明。搬家之后旧地址不存在了,声明只是告诉搜索引擎「以这个为准」,旧地址还能访问。该用301的情况页面永久不存在了,或者内容整体迁移到新地址,用301。比如改版换了URL结构、合并两个重复页面、域名迁移。301会把权重和流量一起带过去,这是它的价值。但它有代价:旧URL彻底失效,用户的书签和外链都会跳转。不可逆,所以要确认是真的不需要旧地址了。该用canonical的情况同一份内容有多个可访问的URL,但你希望保留这些URL。典型场景是带参数的URL、打印版页面、商品筛选产生的组合页。比如/product?id=123和/product/1
robots、noindex和canonical,三个工具怎么分工
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 8次
robots.txt、noindex和canonical,这三个东西看着都跟收录有关,但作用完全不一样。很多站长把它们混着用,结果该收录的没收录,不该收录的反而堆了一堆。搞清楚各自的分工,是做好索引管理的基础。robots.txt管的是"能不能爬"robots.txt控制的是蜘蛛能不能抓取,它是个门卫,拦在抓取这一层。你在这个文件里写Disallow,蜘蛛就不会去爬对应的路径。但要注意,robots拦的是抓取,不是收录。如果一个页面本来已经被收录了,后来才在robots里屏蔽,搜索引擎可能还会在索引里保留它,只是不再更新。所以想下架内容,光靠robots是不够的。noindex管的是"能不能收录"noindex是直接告诉搜索引擎"这个页面不要进索引",它作用
搜索
-
标签列表
联系+Whatsapp+微信
-