当前位置:首页 » 收录 - 第1页

置顶《GEO生成式引擎优化完全指南》-AI搜索时代的品牌曝光与流量增长实战电子书下载
发布 : 闫宝龙 | 分类 : 网络营销 | 评论 : 0 | 浏览 : 428次
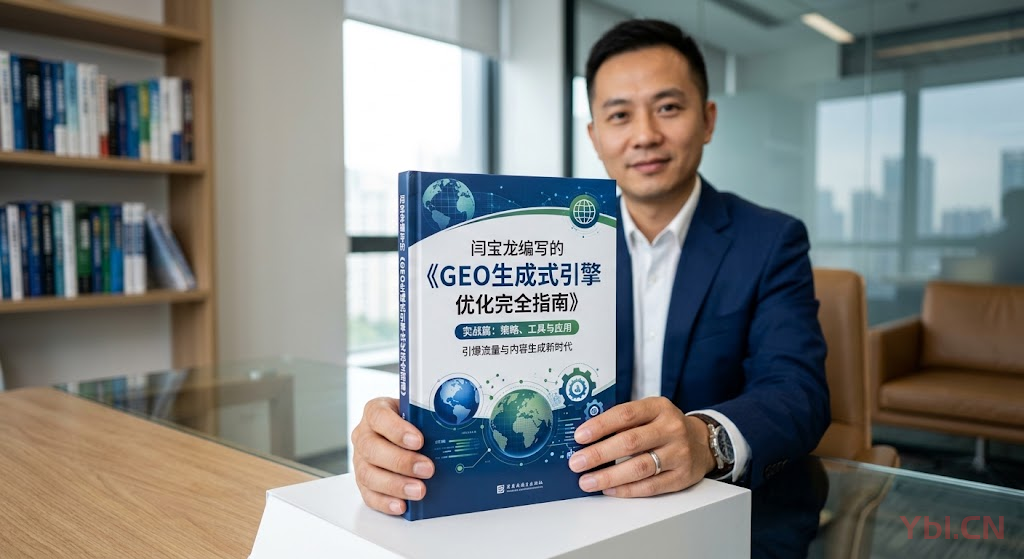
《GEO生成式引擎优化完全指南》-AI搜索时代的品牌曝光与流量增长实战电子书下载GEO生成式引擎优化完全指南.pdf章节主题核心价值第一章GEO时代的到来从SEO到GEO的范式转移,市场数据与窗口期判断第二章GEO技术原理大模型"检索-推理-生成"链路,实体识别与知识图谱第三章GEO内容策略倒金字塔写作、结构化内容、语义熵降低、三层内容矩阵第四章结构化数据与SchemaJSON-LD实战部署,8大核心Schema类型详解第五章权威信源建设S/A/B/C四级信源矩阵,官网优化与全平台分发第六章GEO工具与平台监测工具、内容工具、服务商盘点与选型指南第七章分行业GEO实战电商、B2B、教育、医疗、金融、本地生活、跨境出海第八章效果衡
被收录不等于被引用,这两件事要分开验证
发布 : 闫宝龙 | 分类 : 网络营销 | 评论 : 0 | 浏览 : 39次

有个客户很高兴地跟我说,他们的页面被AI搜索引用了。我问怎么确认的,他说页面能被搜到。这两件事差得远。页面被收录,只说明搜索引擎存了这份内容;被引用,说明某个AI在回答问题时真的用了它。收录怎么验证最直接的是站点查询,看页面在不在索引里。其次看搜索资源平台的收录数据,以及服务器日志里有没有抓取记录。收录是必要条件,没收录一定不会被引用。但收录了,也可能永远不被用。引用怎么验证目前没有统一工具。我的做法是人工提问加记录:围绕核心业务问题,准备二十到三十个问题,定期在几个主流AI助手里问一遍,看答案里有没有提到你、有没有给出你的链接。关键是固定问题、固定工具、固定时间。变量太多,数据就没法比较。为什么收录了却不被引用常见原因有四个。内容太泛,谁都能说,没有引用价值;信息太散,一
蜘蛛访问了页面却没进索引?抓取和收录不是一回事
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 28次
很多站长看到日志里蜘蛛来过,页面状态码还是200,就以为马上会收录了。结果等来等去,页面就是进不了索引。这里面的门道,比想象中多。抓取和收录,根本不是一回事首先要搞清楚一个基本概念:蜘蛛访问了页面,不等于页面被收录。抓取是第一步,收录是后面的独立环节。蜘蛛爬了你的页面,把内容拿回去,还要经过评估、去重、排序等一系列处理,最后才决定要不要放进索引。所以"蜘蛛来过"只是个起点。从抓取到收录,中间隔着好几道关,任何一道卡住,页面都进不了索引。内容质量没达到收录门槛蜘蛛抓取之后,第一个要评估的就是内容值不值得收录。如果你的页面内容太薄、和别人高度重复、或者没有任何独特价值,蜘蛛会觉得"收录你没什么意义",直接丢弃。这就是为什么很多页面明明被抓取了,却一直不收录。内容本身不过关,抓取一百
采集内容收录与排名的影响因素及改善方法
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 1055次

现在很少有做SEO的人能做到整个网站没有抄袭,甚至有些人懒得抄袭,直接收集,到最后一站,虽然文章很多,但投入很少,根本没有排名。为此,外贸云搜索引擎根据自己的经验进行优化,共享逐步收集的内容输入和排名方法。 1、影响进入排名的因素有哪些? 一个搜索引擎,其核心价值是向用户提供他们最需要的结果。搜索引擎有计算网民的需求,对于网民需求量小或几乎没有内容需求,即使你是原创的也可能被搜索引擎忽略,因为它不想在毫无意义的内容上浪费资源。 网民需要大量的内容应该输入得更快,但由于输入量多,即使你是原创的,也很难挤进排名。 外贸云认为网站关键词需要排名,首先需要输入,只要输入
搜索
-
标签列表
联系+Whatsapp+微信
-